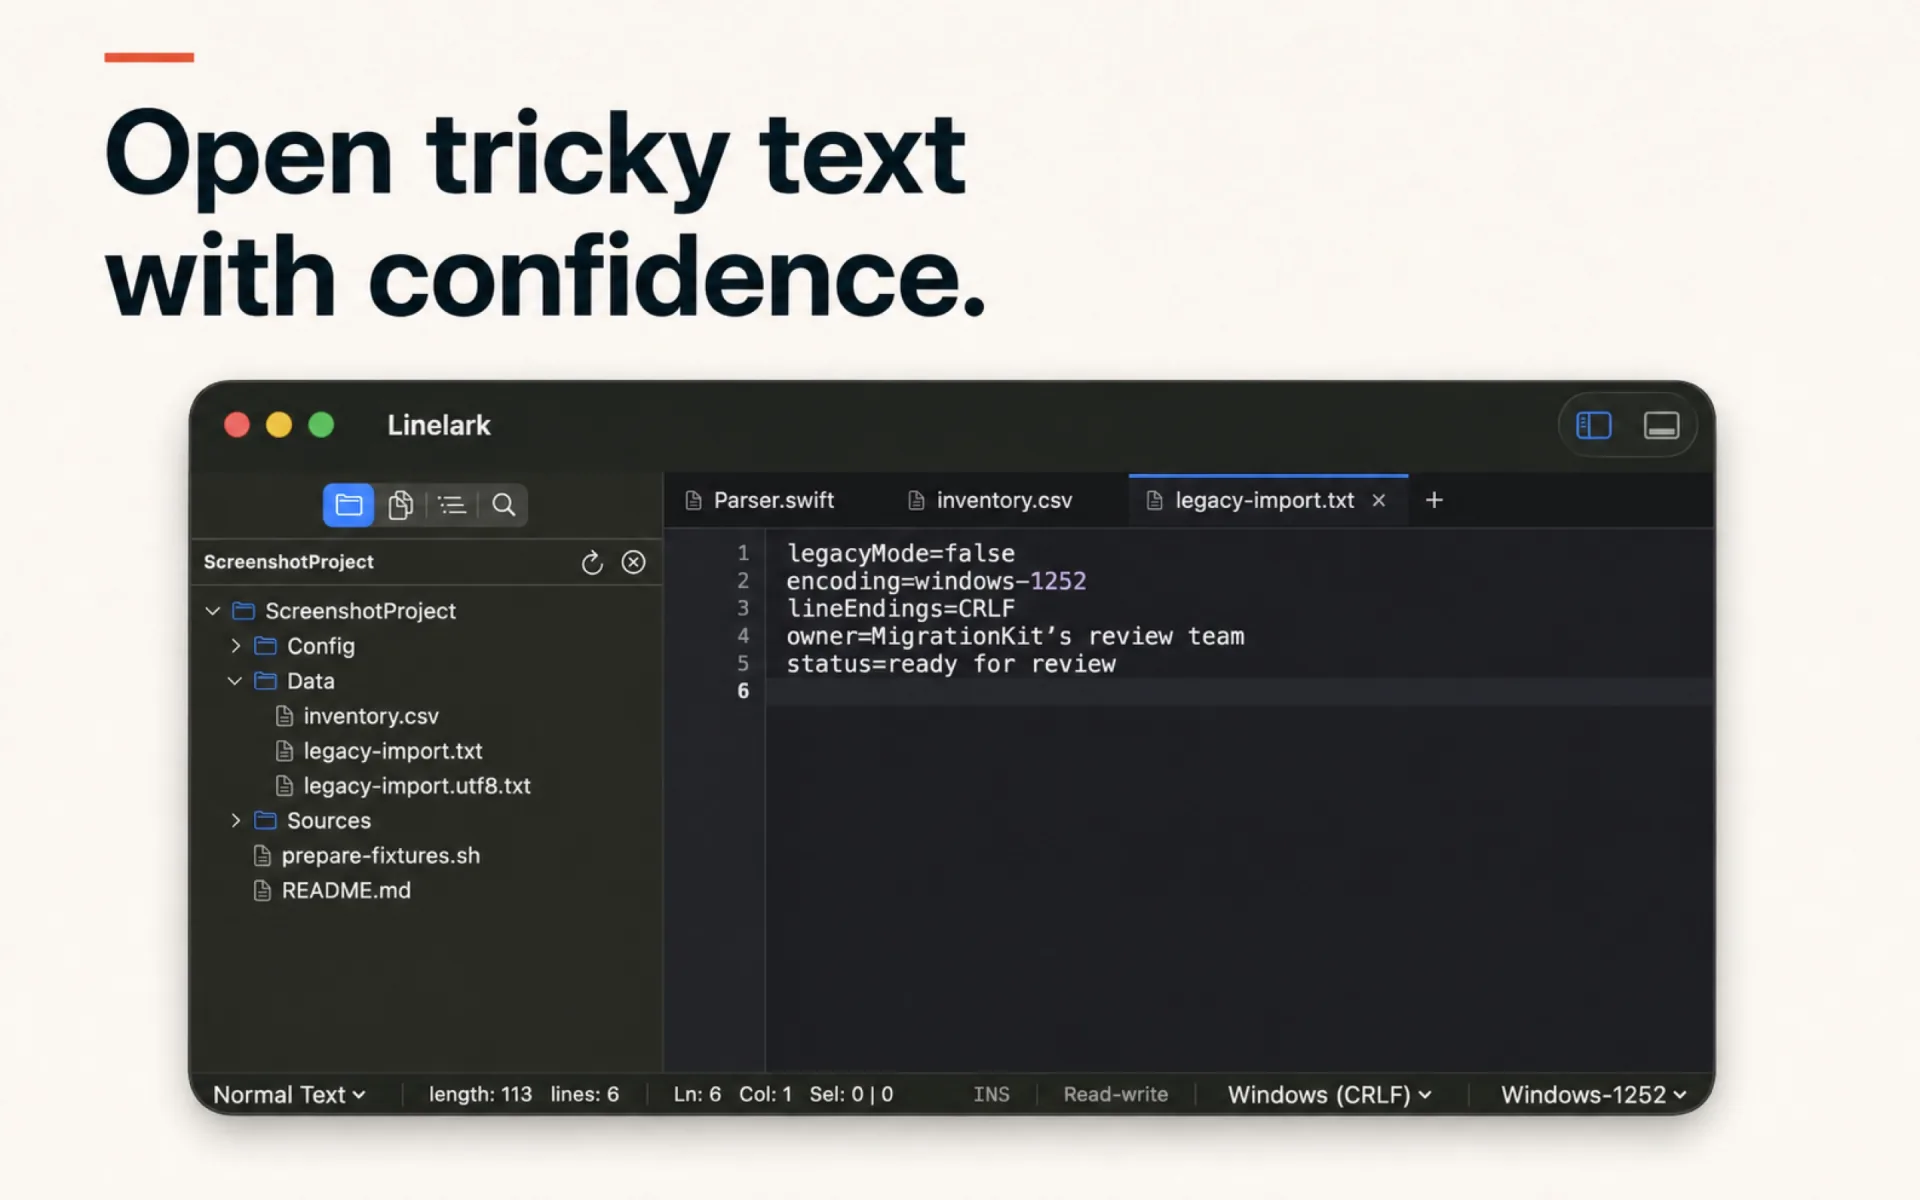
01La détection a lieu à l’ouverture
Une marque d’ordre des octets tranche la question d’emblée. Sans elle, le fichier est décodé en essayant les encodages plausibles, pour qu’un fichier UTF-8 sans BOM ne soit pas pris pour du Latin-1 à cause d’un seul octet haut.
02L’encodage est porté par le document
Ce n’est pas un réglage global. Deux onglets peuvent contenir deux encodages, et chacun s’enregistre dans le sien.
03Réinterpréter relit, convertir réécrit
Réinterpréter reprend les octets sur le disque et les décode à nouveau avec l’encodage que vous choisissez — le remède quand un fichier s’est ouvert comme autre chose. Convertir change ce qui sera écrit. Une seule des deux modifie le fichier.
04Les fins de ligne sont un axe à part
LF, CRLF et CR sont suivis séparément de l’encodage et affichés séparément, parce que les fins de ligne d’un fichier et son jeu de caractères n’ont rien à voir l’un avec l’autre.
05Un BOM est un choix, pas un accident
L’UTF-8 est proposé avec et sans marque d’ordre des octets, en deux entrées distinctes, parce que pour un script shell la différence décide s’il s’exécute.
06Le remplacement sur dossier hérite de tout cela
Remplacer dans les fichiers décode chaque fichier avec son propre encodage et le réécrit à l’identique, pour qu’une modification en masse ne devienne jamais une conversion en masse.